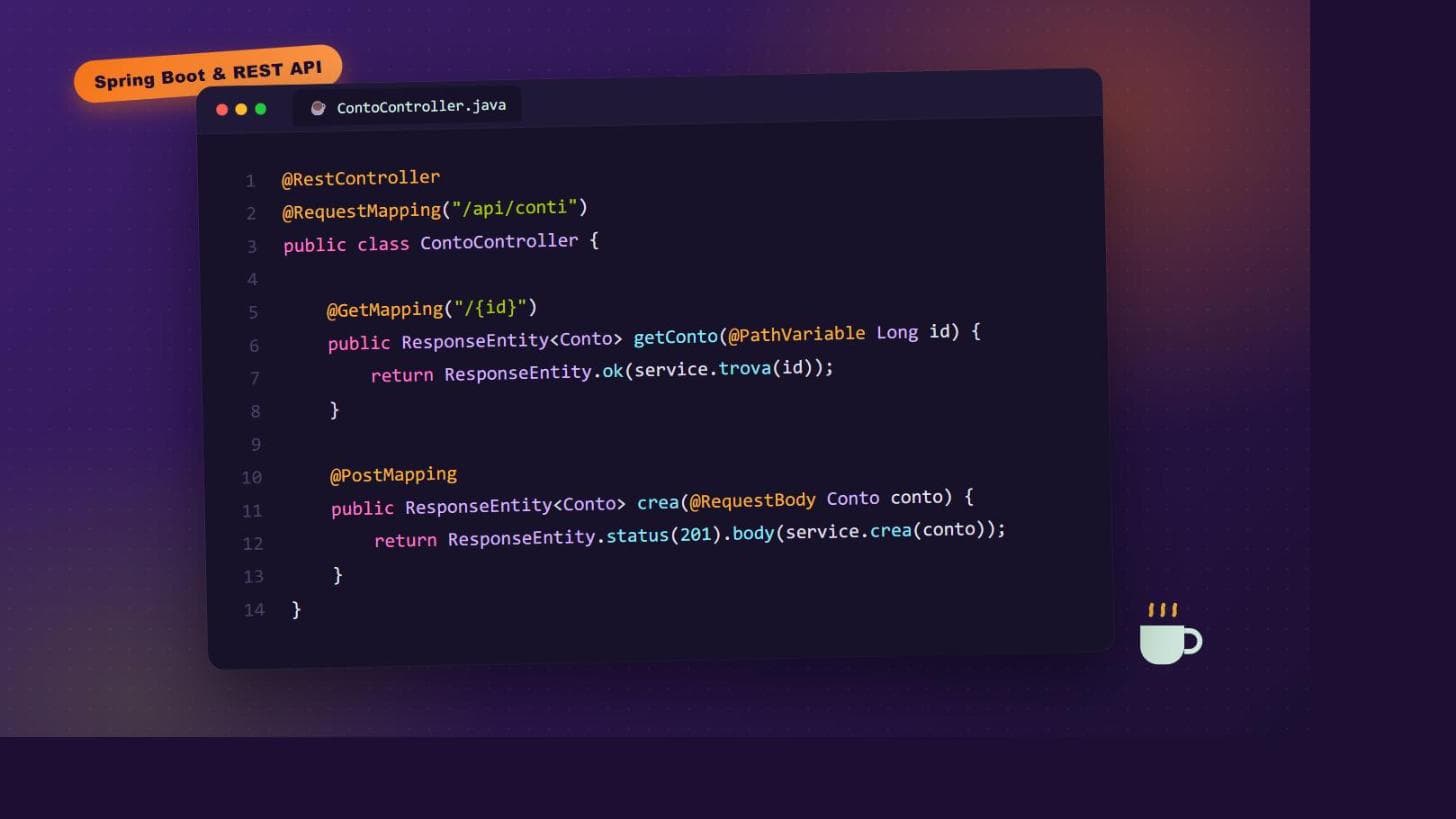
Prima di iniziare · Sviluppo web con Spring Boot: il corso pratico
Se stai muovendo i primi passi nel codice, probabilmente ti è già piovuta addosso una valanga di parole d'ordine da colloquio tecnico: endpoint, payload, architettura client-server, scalabilità, disaccoppiamento e l'immancabile REST API.
Tutti sembrano dare questi concetti per scontati. La realtà? Per un dev junior, o per chi fino a ieri campava assemblando plugin su WordPress, il salto concettuale non è affatto banale.
Cosa fai a quel punto? Cerchi su Google o chiedi a un'AI. Il risultato oscilla tra due estremi: da un lato la tesi accademica respingente, dall'altro il tutorial da cinque minuti su YouTube che mostra come fare una chiamata fetch senza spiegare perché la stai facendo.
Mettiamo da parte i formalismi e affrontiamo la questione con un po' di sano pragmatismo.
Ma prima: come si lavorava ai tempi?
Immagina di essere il classico sviluppatore web a cavallo tra il 2008 e il 2012 (internet era invaso da annunci di lavoro come "Wordpress specialist" o "Wordpress Developer". Io c'ero, e questi annunci me li sogno ancora). La prassi dell'epoca era brutale: modifiche al codice in locale, upload via FTP dritto nell'ambiente di produzione e, quasi sempre, la White Screen of Death (sito irraggiungibile e sudori freddi in tempo reale).
Tutto risiedeva nello stesso identico calderone: markup HTML, fogli di stile CSS, query SQL e logica di business. Il tipico monolite: il server riceveva la richiesta dal browser, macinava il codice PHP, interrogava il database e sputava fuori una pagina HTML già interamente renderizzata e impacchettata.
Finché l'unico target era il browser desktop, andava bene così: tu fatturavi, il cliente vedeva il sito, tutti felici.
Poi sono arrivati gli smartphone con le app native, i dispositivi IoT, gli assistenti vocali e le Single Page Application. Tutti sistemi a cui di una pagina HTML precompilata non serve assolutamente nulla: hanno bisogno solo di dati grezzi da manipolare autonomamente. Da qui l'esigenza di spezzare il monolite e separare i layer.
Che cos'è davvero un'API REST?
Un'API (Application Programming Interface) è un contratto di comunicazione: un livello di astrazione che permette a due sistemi distinti di dialogare senza che l'uno debba conoscere l'architettura interna dell'altro.
REST (Representational State Transfer) è lo stile architetturale che definisce le regole di questo scambio sul web, sfruttando il protocollo che manda avanti internet da decenni: l'HTTP.
L'analogia più calzante è la presa elettrica a muro:
- La presa fornisce un'interfaccia standard (i fori a una determinata distanza, un voltaggio preciso).
- Qualsiasi elettrodomestico dotato della spina conforme può collegarsi e attingere energia.
- L'aspirapolvere non ha bisogno di sapere come sono posati i cavi dietro il muro, né se l'energia arriva da una centrale idroelettrica o da un pannello solare. L'interfaccia isola il consumatore dal fornitore.
Il formato dei dati: perché domina il JSON?
Per dialogare, client e server devono parlare la stessa lingua. Oggi lo standard de facto è il JSON (JavaScript Object Notation): leggero, privo di fronzoli, facilissimo da parsare per qualsiasi linguaggio moderno e immediatamente leggibile da noi umani.
Un chiarimento fondamentale: REST non impone l'uso di JSON.
REST è indipendente dal formato. Per anni l'XML ha dominato la scena, spesso affiancato al protocollo SOAP (tuttora vivo nei sistemi bancari e enterprise legacy). Un'API che scambia payload XML rispettando i vincoli di REST è a tutti gli effetti un'API REST valida. Semplicemente, l'industria ha eletto JSON a standard universale perché elimina la pesantezza sintattica e il parsing verboso dei tag XML.
Gli elementi costitutivi: cosa rende un'API "REST"?
Un'API è RESTful quando sfrutta le feature native del protocollo HTTP invece di reinventare la ruota. Si basa su tre pilastri:
1. Le Risorse (Endpoint)
In REST tutto è una risorsa, identificata da un URL composto da sostantivi (mai verbi):
/utenti/conti/transazioni
2. I Verbi HTTP (Le azioni)
Invece di creare endpoint procedurali come /ottieniSaldo o /cancellaAccount, l'azione da compiere è espressa dal verbo HTTP:
- GET: Recupera un dato (es. GET /conti/123 → Dammi i dati del conto 123).
- POST: Crea una nuova risorsa (es. POST /bonifici con il payload dei dettagli → Esegui questo bonifico).
- PUT / PATCH: Aggiorna un dato esistente (PUT rimpiazza l'intera risorsa, PATCH aggiorna solo i campi specificati).
- DELETE: Rimuove una risorsa (es. DELETE /sessioni/current → Effettua il logout).
3. Gli Status Code (Il semaforo di ritorno)
Il server comunica l'esito della richiesta tramite codici numerici standardizzati:
- 200 OK / 201 Created: Operazione riuscita con successo.
- 400 Bad Request: Errore lato client: dati mancanti, formattazione non valida o tipi errati.
- 401 Unauthorized: Non so chi sei: autenticazione assente o fallita.
- 403 Forbidden: So chi sei, ma non ti è permesso: autorizzazione negata.
- 404 Not Found: La risorsa richiesta non esiste.
- 500 Internal Server Error: Errore non gestito nel backend o database irraggiungibile.
Dietro le quinte: la Business Logic
In mezzo al flusso tra il client e la base dati si colloca la Business Logic (o logica di dominio). Riprendendo l'esempio bancario, la business logic è il set di regole che scatta prima di alterare qualsiasi record sul database:
- Disponibilità: Il saldo attuale copre l'importo richiesto più le relative commissioni?
- Limiti operativi: Il prelievo rispetta il massimale giornaliero configurato per quel bancomat?
- Stato dell'account: Il conto è attivo, operativo e privo di blocchi cautelativi?
È molto più di ciò, ma è un pezzo del grande puzzle; la business logic risiede esclusivamente nel backend ed è il motore decisionale dell'applicazione. È separata dalla persistenza (il database memorizza e basta) e dall'API (l'endpoint definisce solo la porta d'ingresso).
Separation of Concerns: ognuno al proprio posto
Questo modello architetturale incarna il principio della Separation of Concerns (separazione delle responsabilità): ogni strato del sistema risolve un unico problema e ignora i dettagli implementativi degli altri.
- Client (Frontend / App Mobile): Gestisce l'interfaccia utente, raccoglie input e visualizza le risposte.
- API Layer: Funge da dogana e contratto formale: convalida la struttura delle richieste e serializza i dati.
- Business Logic: Elabora, verifica e applica le regole del business.
- Database: Garantisce la persistenza e l'integrità dei dati sul disco.
Perché questo approccio è infinitamente superiore al vecchio script PHP monolitico? Perché rende l'architettura modulare e rimpiazzabile. Se domani il team decidesse di riscrivere il backend migrando da Java a Go, le applicazioni client (iOS, Android, web) non se ne accorgeranno: continueranno a invocare gli stessi identici endpoint, con gli stessi payload JSON. Lo stesso vale per la persistenza: passare da MySQL a PostgreSQL impatta l'accesso ai dati, non l'interfaccia esposta al mondo esterno.
Il principio cardine: l'architettura è Stateless
Una delle regole fondamentali di REST è l'assenza di stato: ogni singola richiesta deve viaggiare portando con sé tutto il contesto necessario per essere elaborata (token di autenticazione, parametri, identificativi).
Il server non conserva memoria di chi sei tra una chiamata e l'altra. Questo abilita la vera scalabilità orizzontale e l'alta disponibilità: se una richiesta finisce sul Server A e quella immediatamente successiva atterra sul Server B (perché A è sovraccarico o è crashato), l'operazione va a buon fine senza attriti.
| Aspetto | Stateful (monolite classico) | Stateless (architettura REST) |
|---|---|---|
| Gestione dello stato | Il server crea una sessione e memorizza lo stato dell'utente nella propria memoria RAM. | Il server non memorizza sessioni in locale: ogni richiesta include le credenziali (es. JWT). |
| Vincolo sull'infrastruttura | Sticky Sessions: il client deve essere instradato sempre verso lo stesso identico server che ha aperto la sessione. | Totale disaccoppiamento: qualsiasi nodo del cluster può gestire qualsiasi richiesta in qualunque momento. |
| Crash di un nodo | L'utente perde la sessione, il carrello o l'operazione in corso e deve rieffettuare il login. | Trasparente per l'utente: il bilanciatore di carico devia la richiesta su un nodo sano. |
| Scalabilità orizzontale | Complessa: richiede la sincronizzazione in tempo reale della memoria tra tutti i server del cluster. | Lineare: basta aggiungere nuovi nodi dietro al load balancer, senza condividere memoria di sessione. |
Conclusione
Passare dalla visione del monolite centralizzato alla logica disaccoppiata delle REST API segna il passaggio dal semplice assemblaggio di script alla progettazione di sistemi software modulari, manutenibili e pronti a scalare.
Dario Amato
Sviluppatore software
Informatico con 15 anni di esperienza nello sviluppo software, guidato da una forte curiosità per le nuove frontiere dell'AI e del Web Marketing.